Moin, wollte ich eigentlich gestern schon schreiben, gemma4 hat ein neues 12B Modell veröffentlicht, das auch auf Hardware mit 16GB Ram laufen soll. Damit gibt es gemma4 jetzt in E2B, E4B, 12B, 26B (a3b) und 31b.
Die E2B oder E4B könnten vielleicht auch interessant für den Raspi sein. Auf dem Handy laufen die ja offline schon gut.
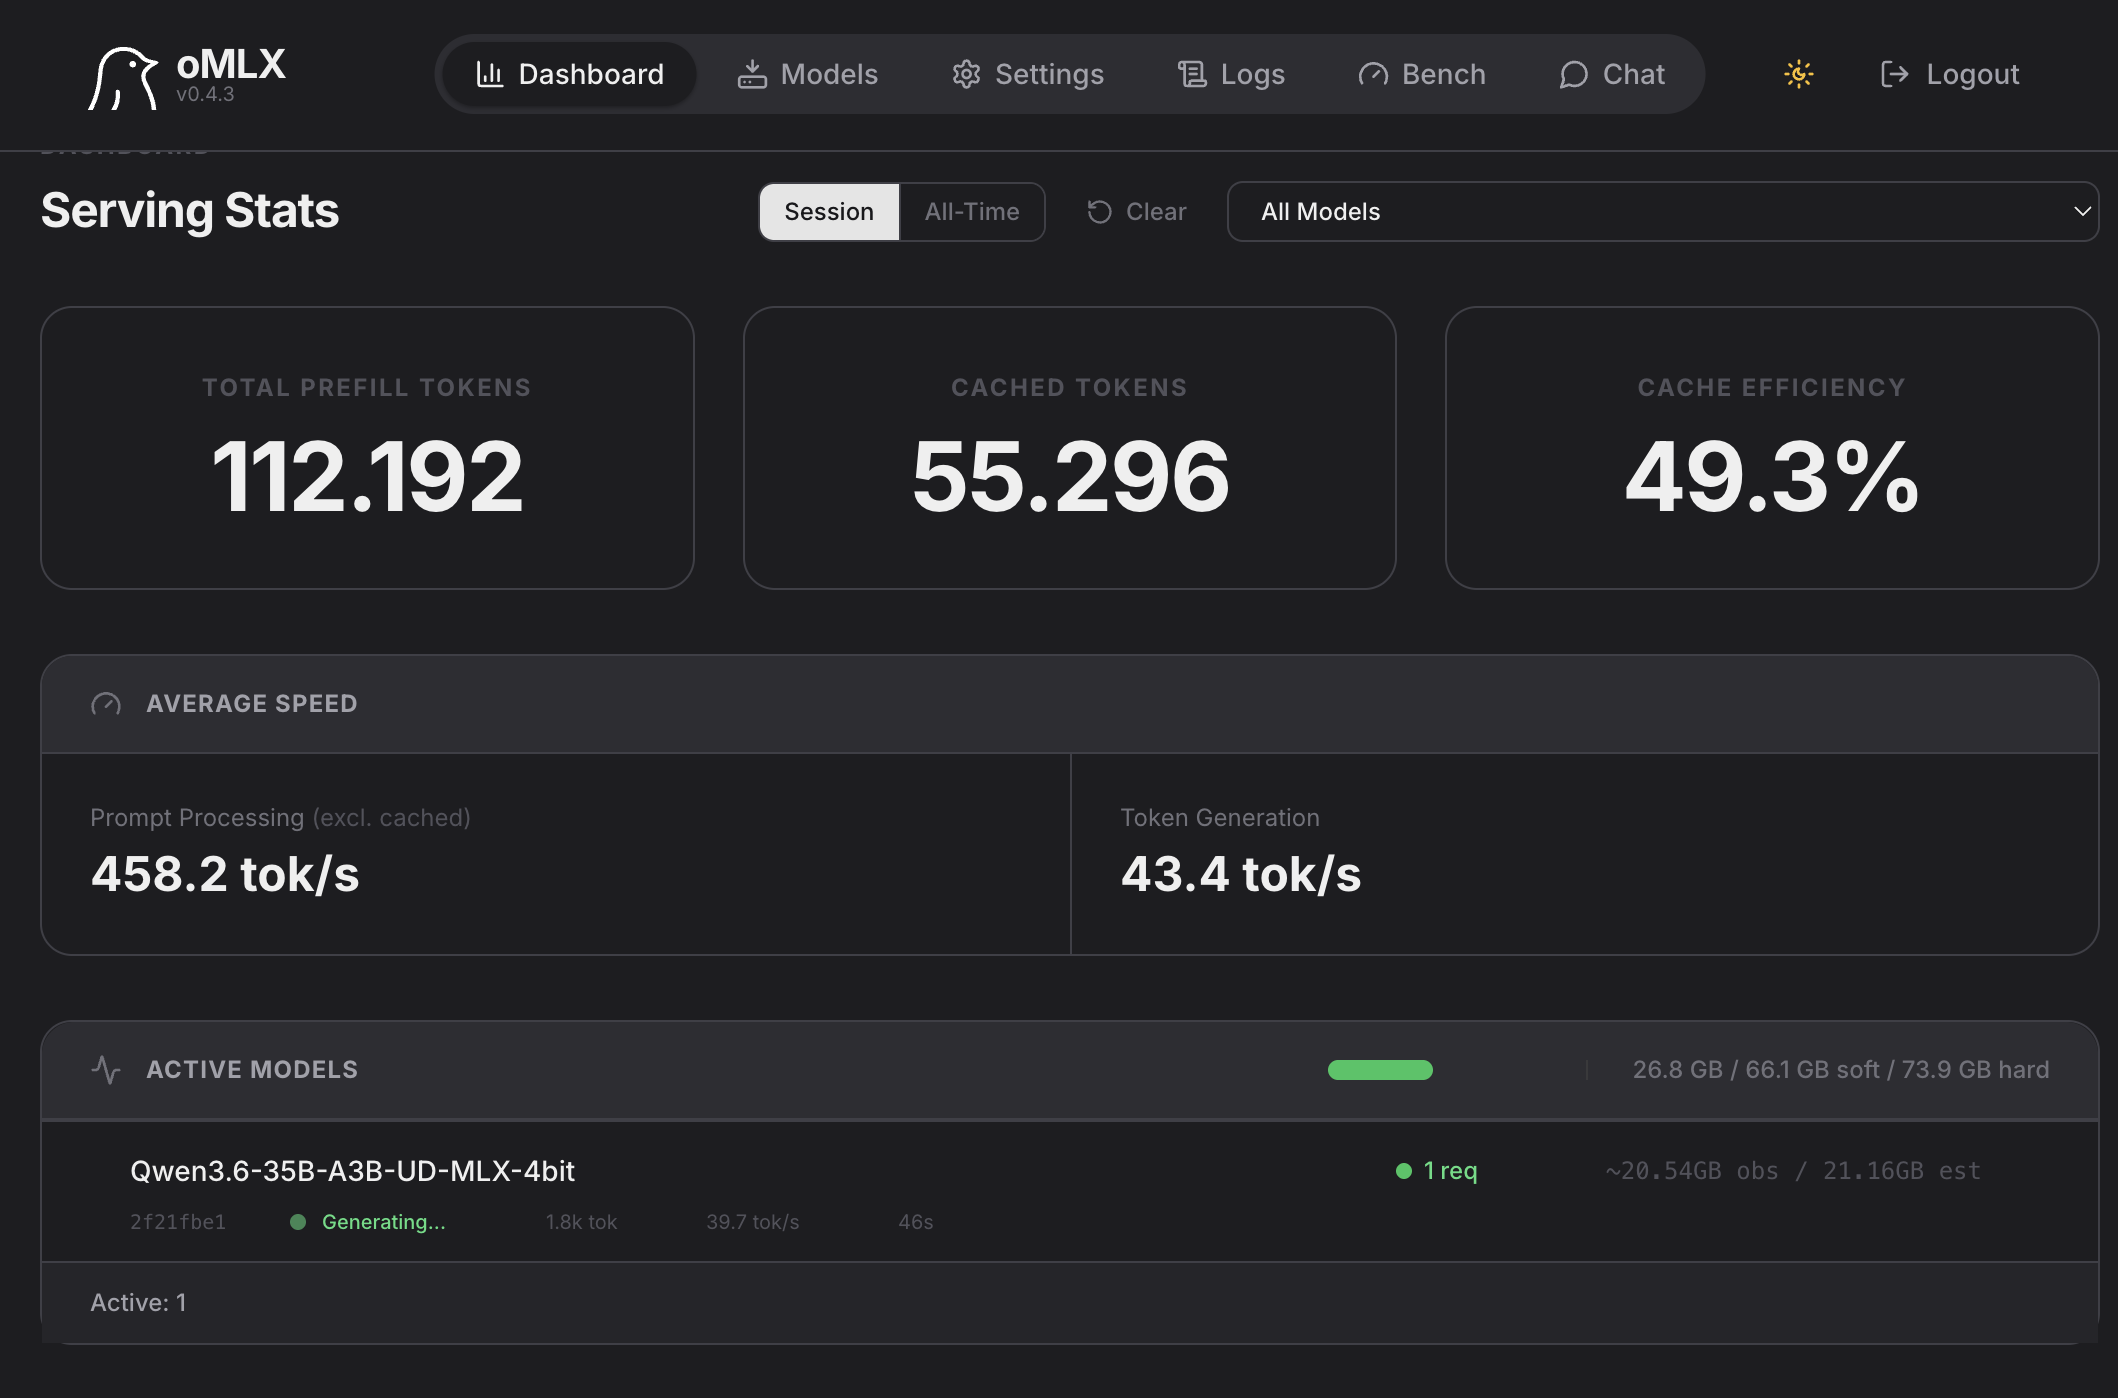
Ich habe gestern Abend noch etwas spielen können. Habe jetzt mal das Qwen3.6-35B-A3B-4bit laufen lassen mit 21GB RAM und die 8bit Version will ich laden, dauert aber immer ewig und die knapp 38GB habe ich daher nicht mehr geschafft komplett herunterzuladen, wird dann heute nachgeholt und aktuell schon geladen.
Die 4bit Variante läuft auf jeden Fall sehr flott und nun sind auch lange Context Eingaben und Antworten möglichen. Er war mal kurzzeitig auf von 21GB auf 58GB angewachsen, der Context nimmt dann also schon viel ein und die Ergebnisse werden entsprechend besser wenn der RAM dann halt auch zur Verfügung steht.
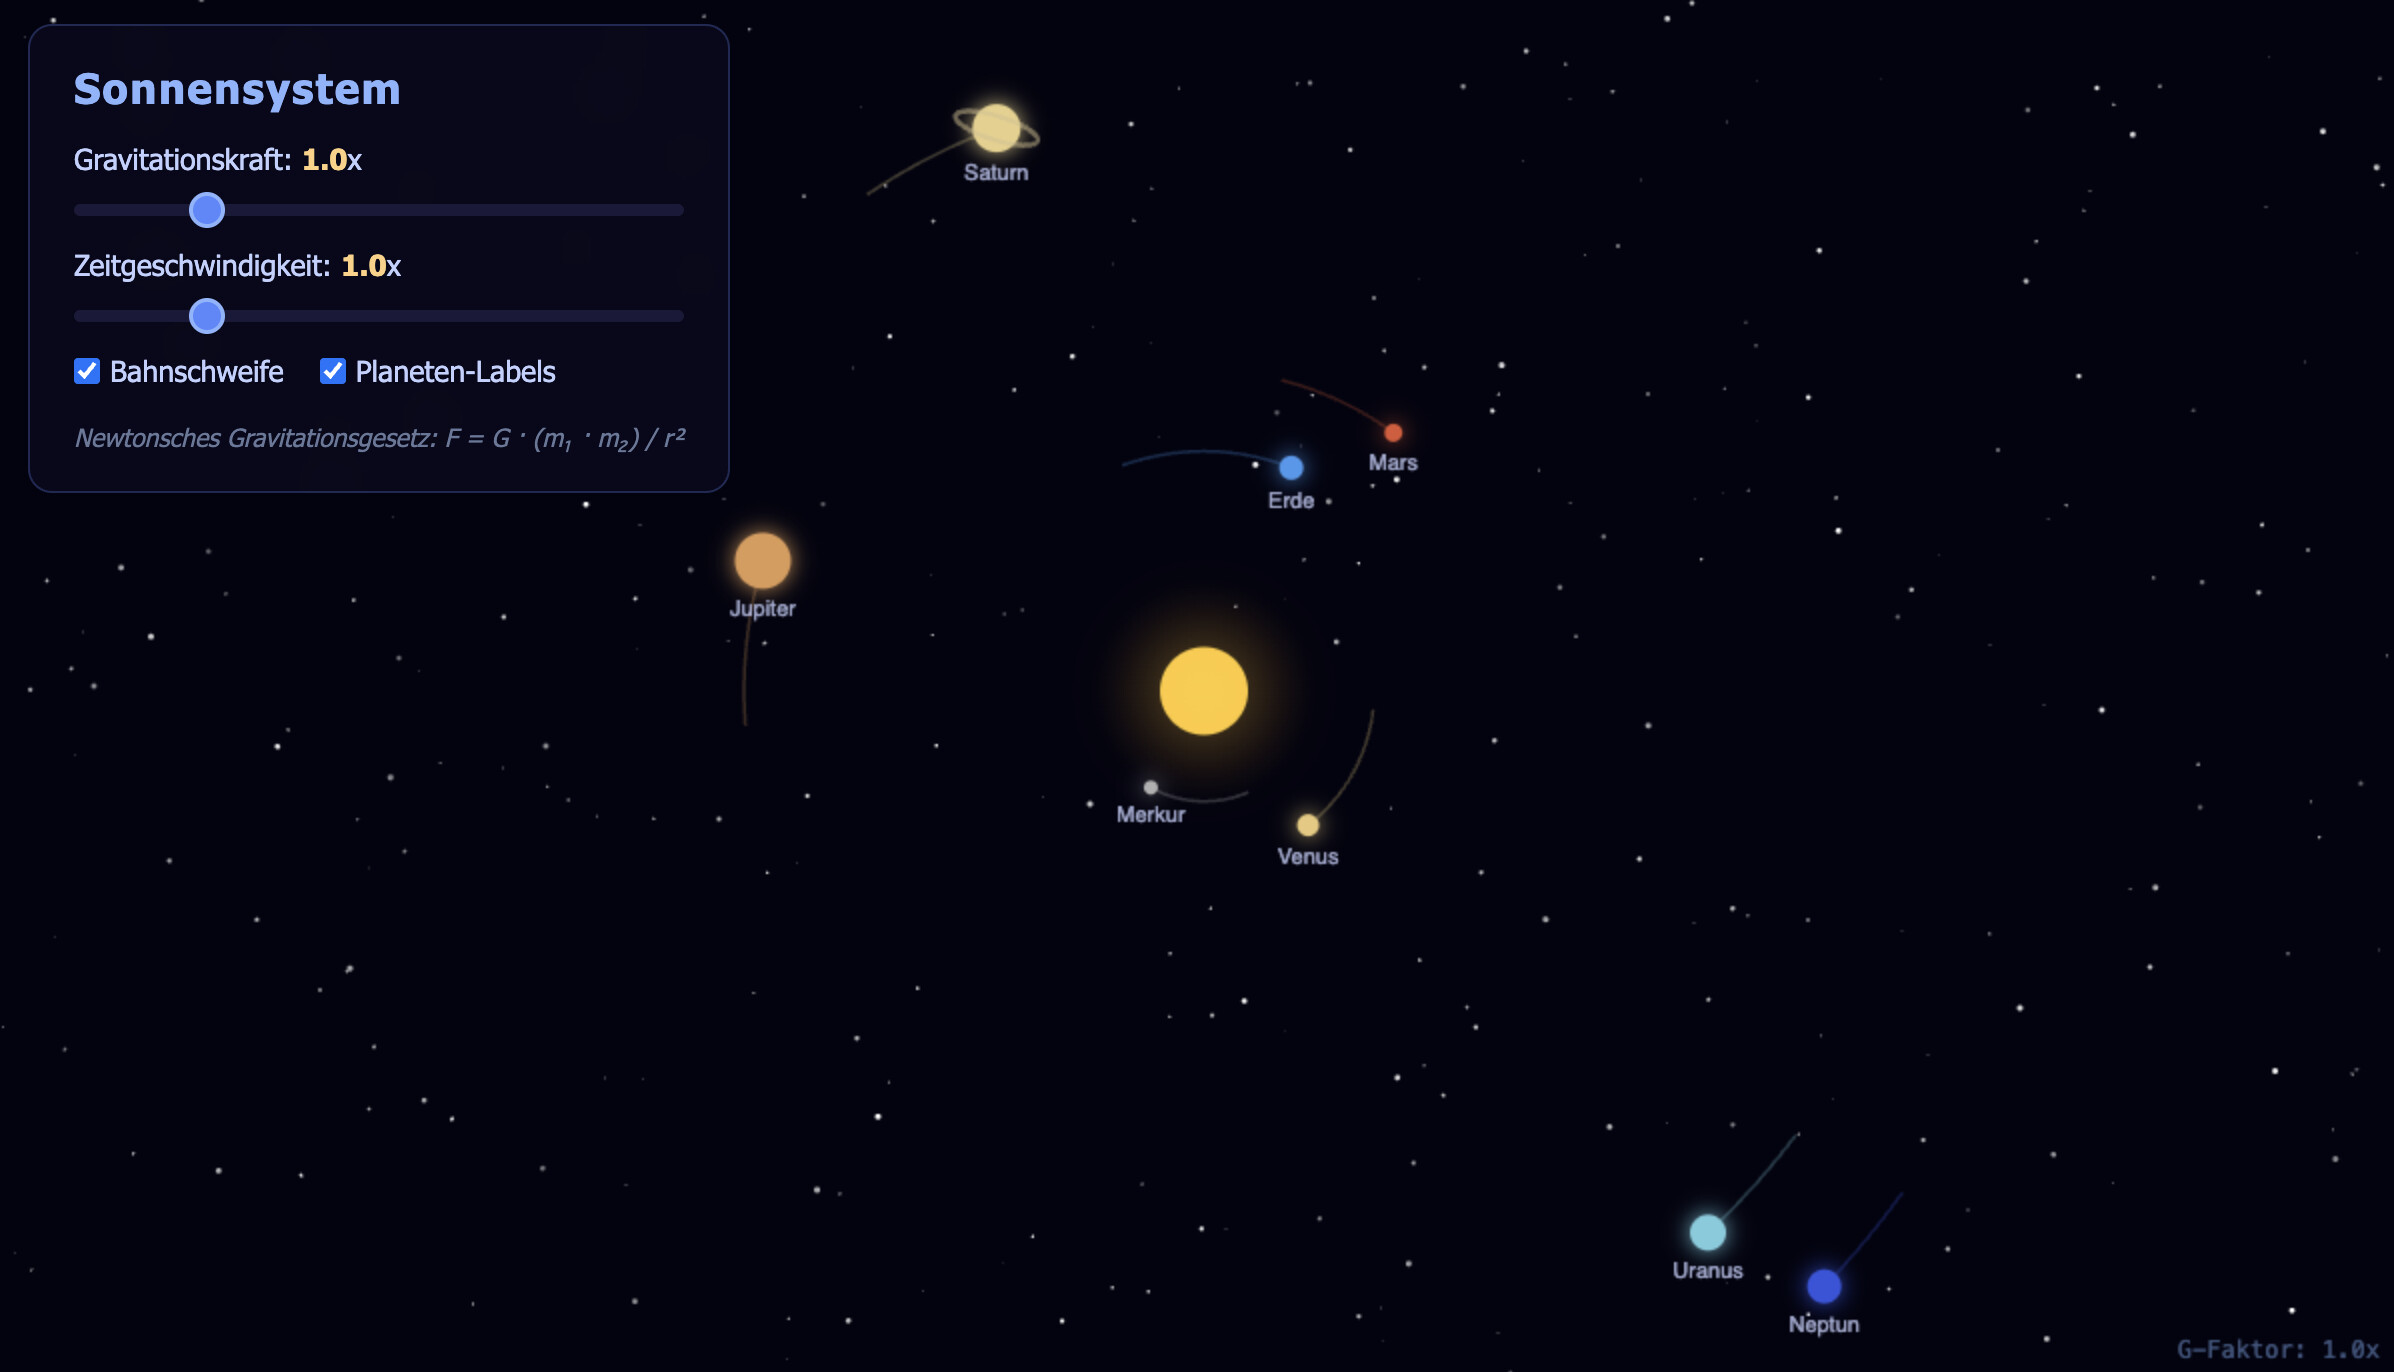
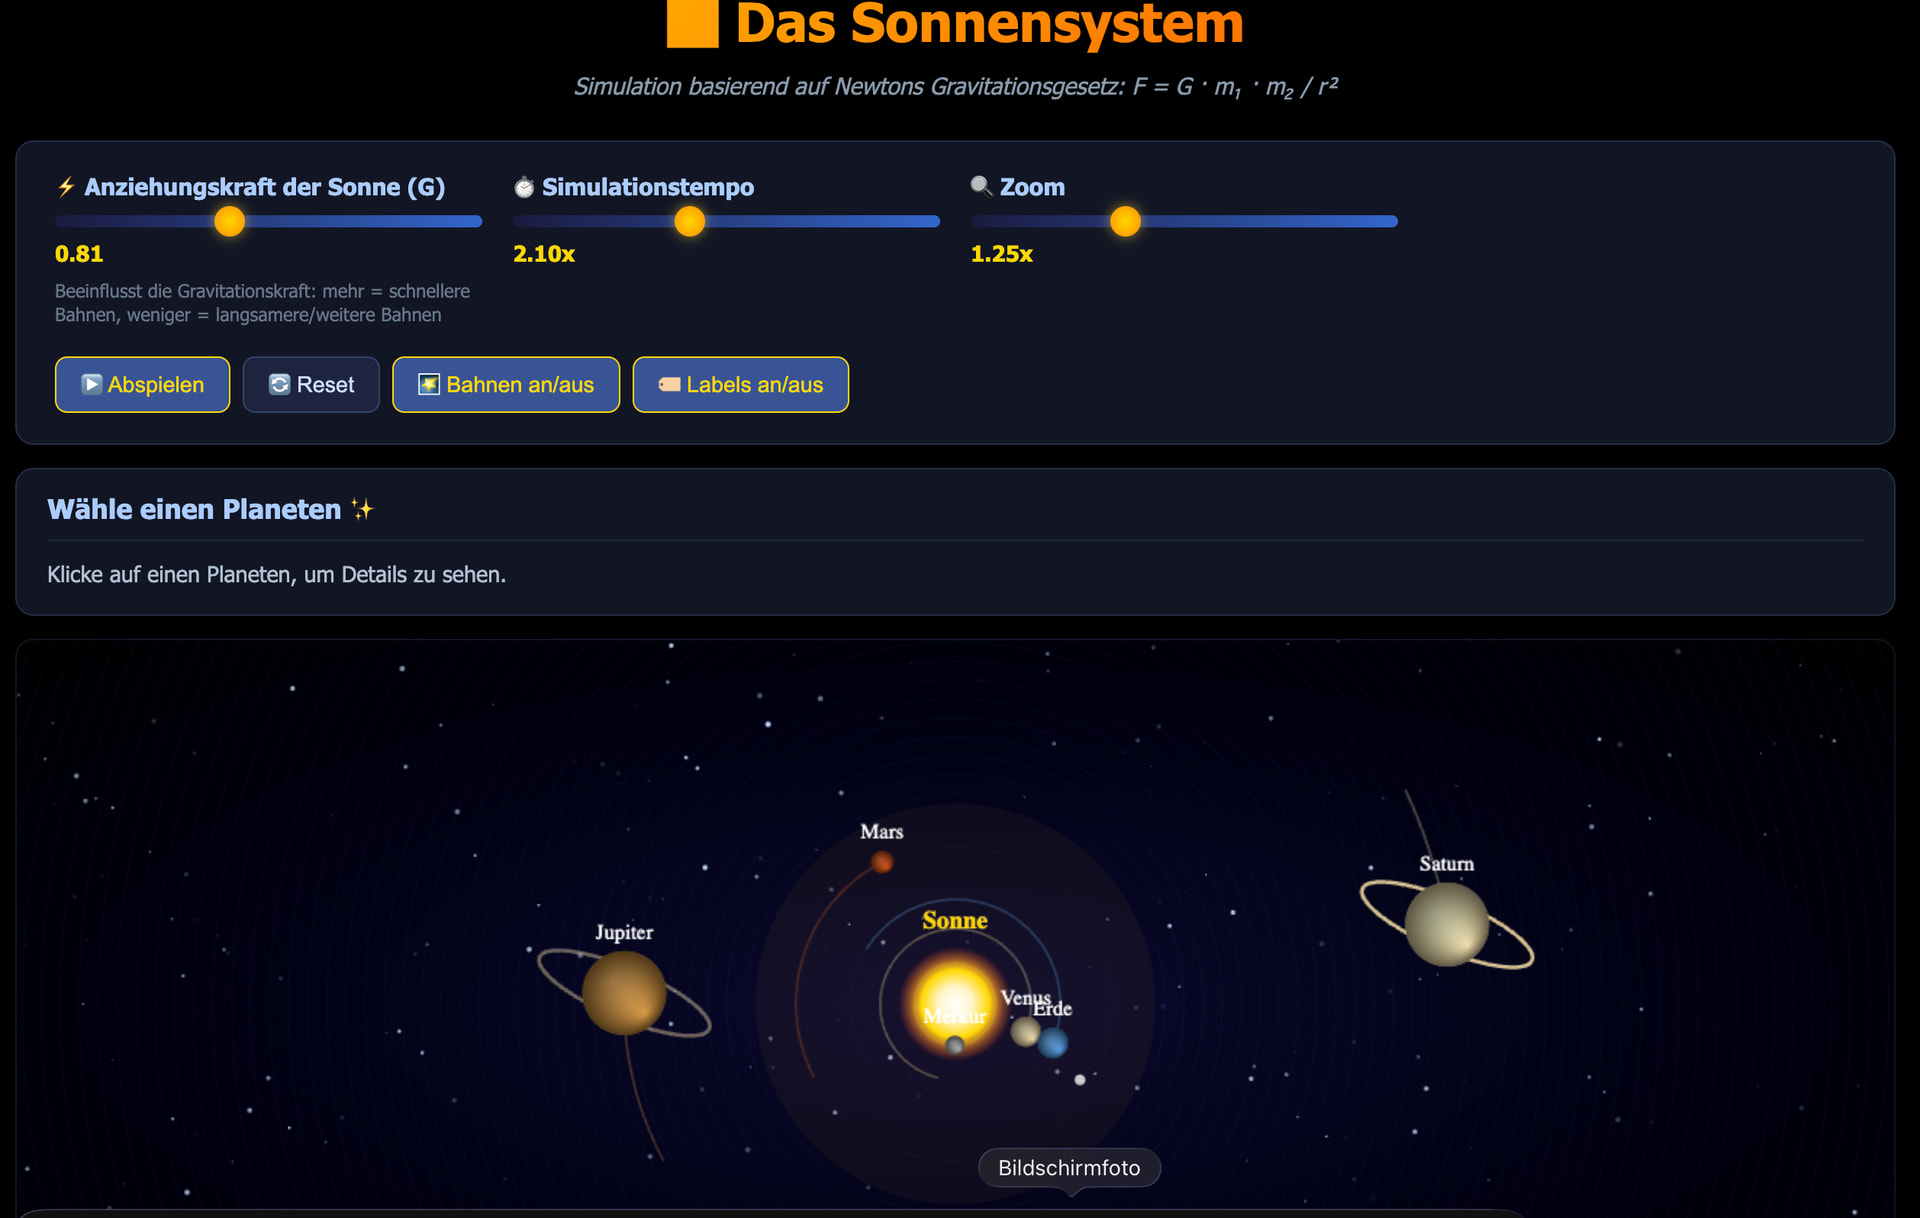
Habe dann wie immer meine Standardaufgabe zum Sonnensystem gestellt und habe direkt bei der ersten Antwort ein absolut brauchbares Ergebnis erhalten, echt der Hammer.
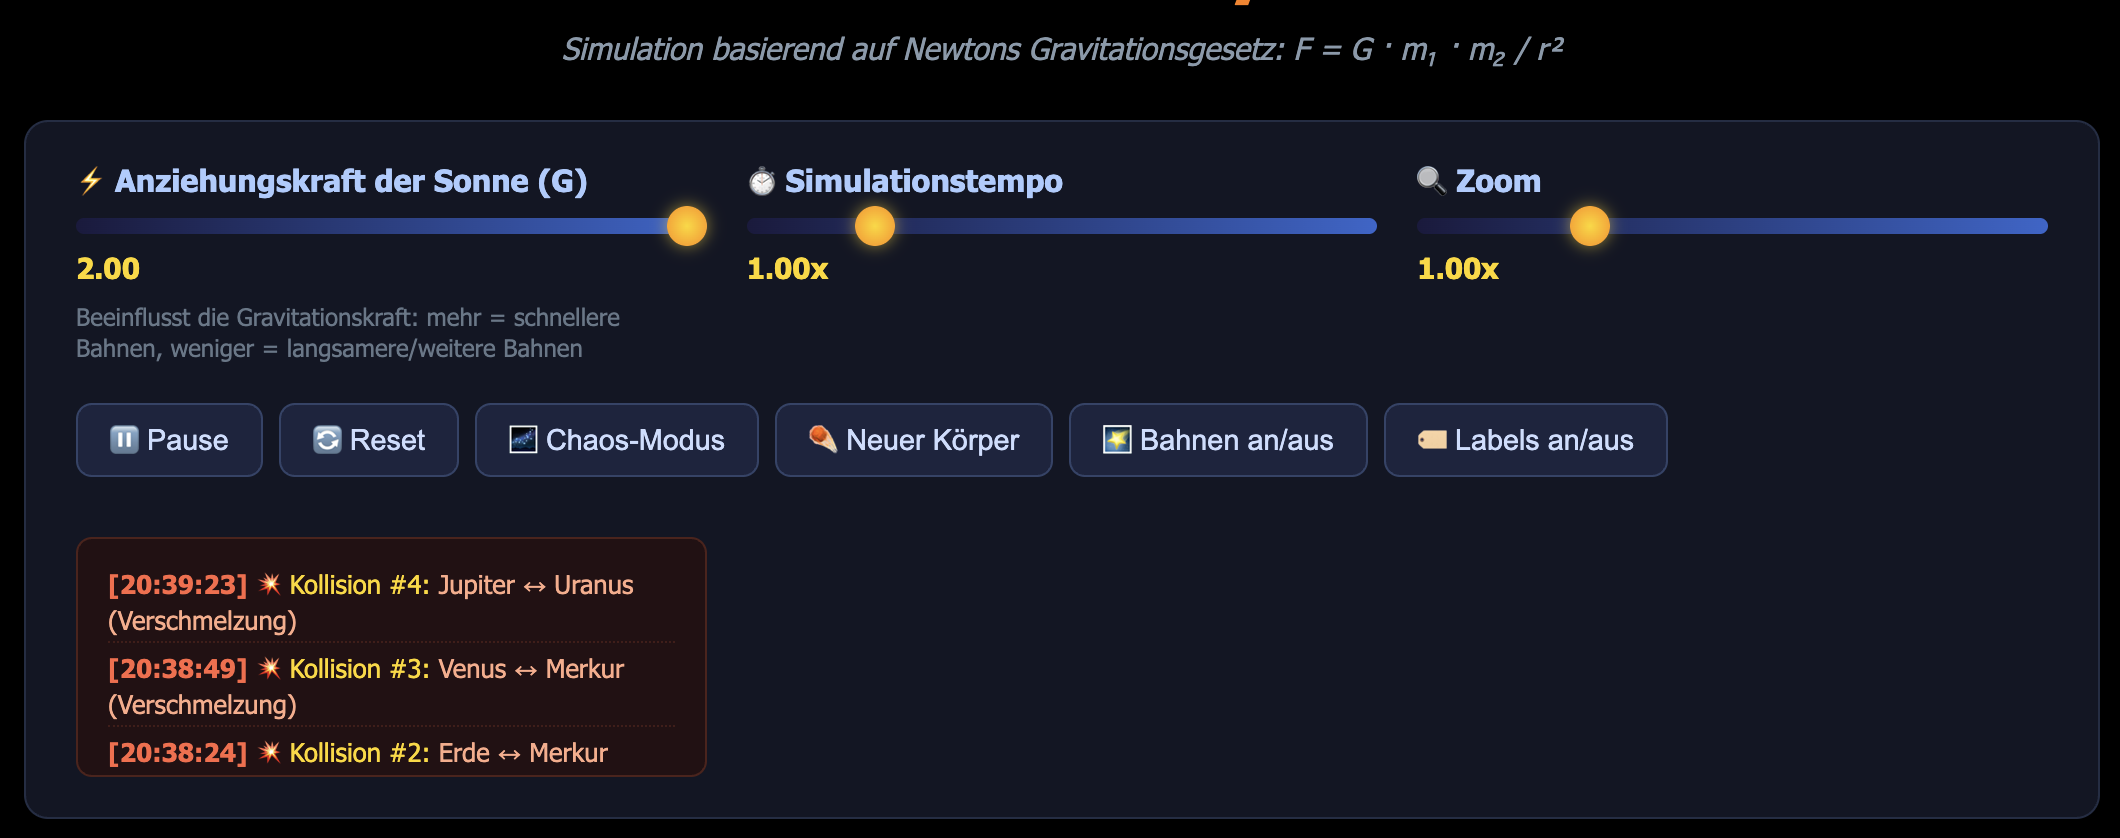
Es kamen auch gleich Vorschläge was noch verbessert werden kann und dann habe ich ihn mal machen lassen. Herausgekommen ist ein Chaos-Modus oder Kollisionseffekte zwischen Planeten. Sogar interstellares Objekte kann man jetzt einfügen und mit in die Animation aufnehmen (Physik läuft trotzdem korrekt). Echt stark für ein lokales LLM.
Heute teste ich dann noch die 8Bit Variante und eine deepseek v4 flash Variante habe ich auch gefunden, die ich lokal laufen lassen kann. Mal schauen wie die so ist, braucht dann aber schon 74GB RAM (bleibt wieder weniger für den Context)
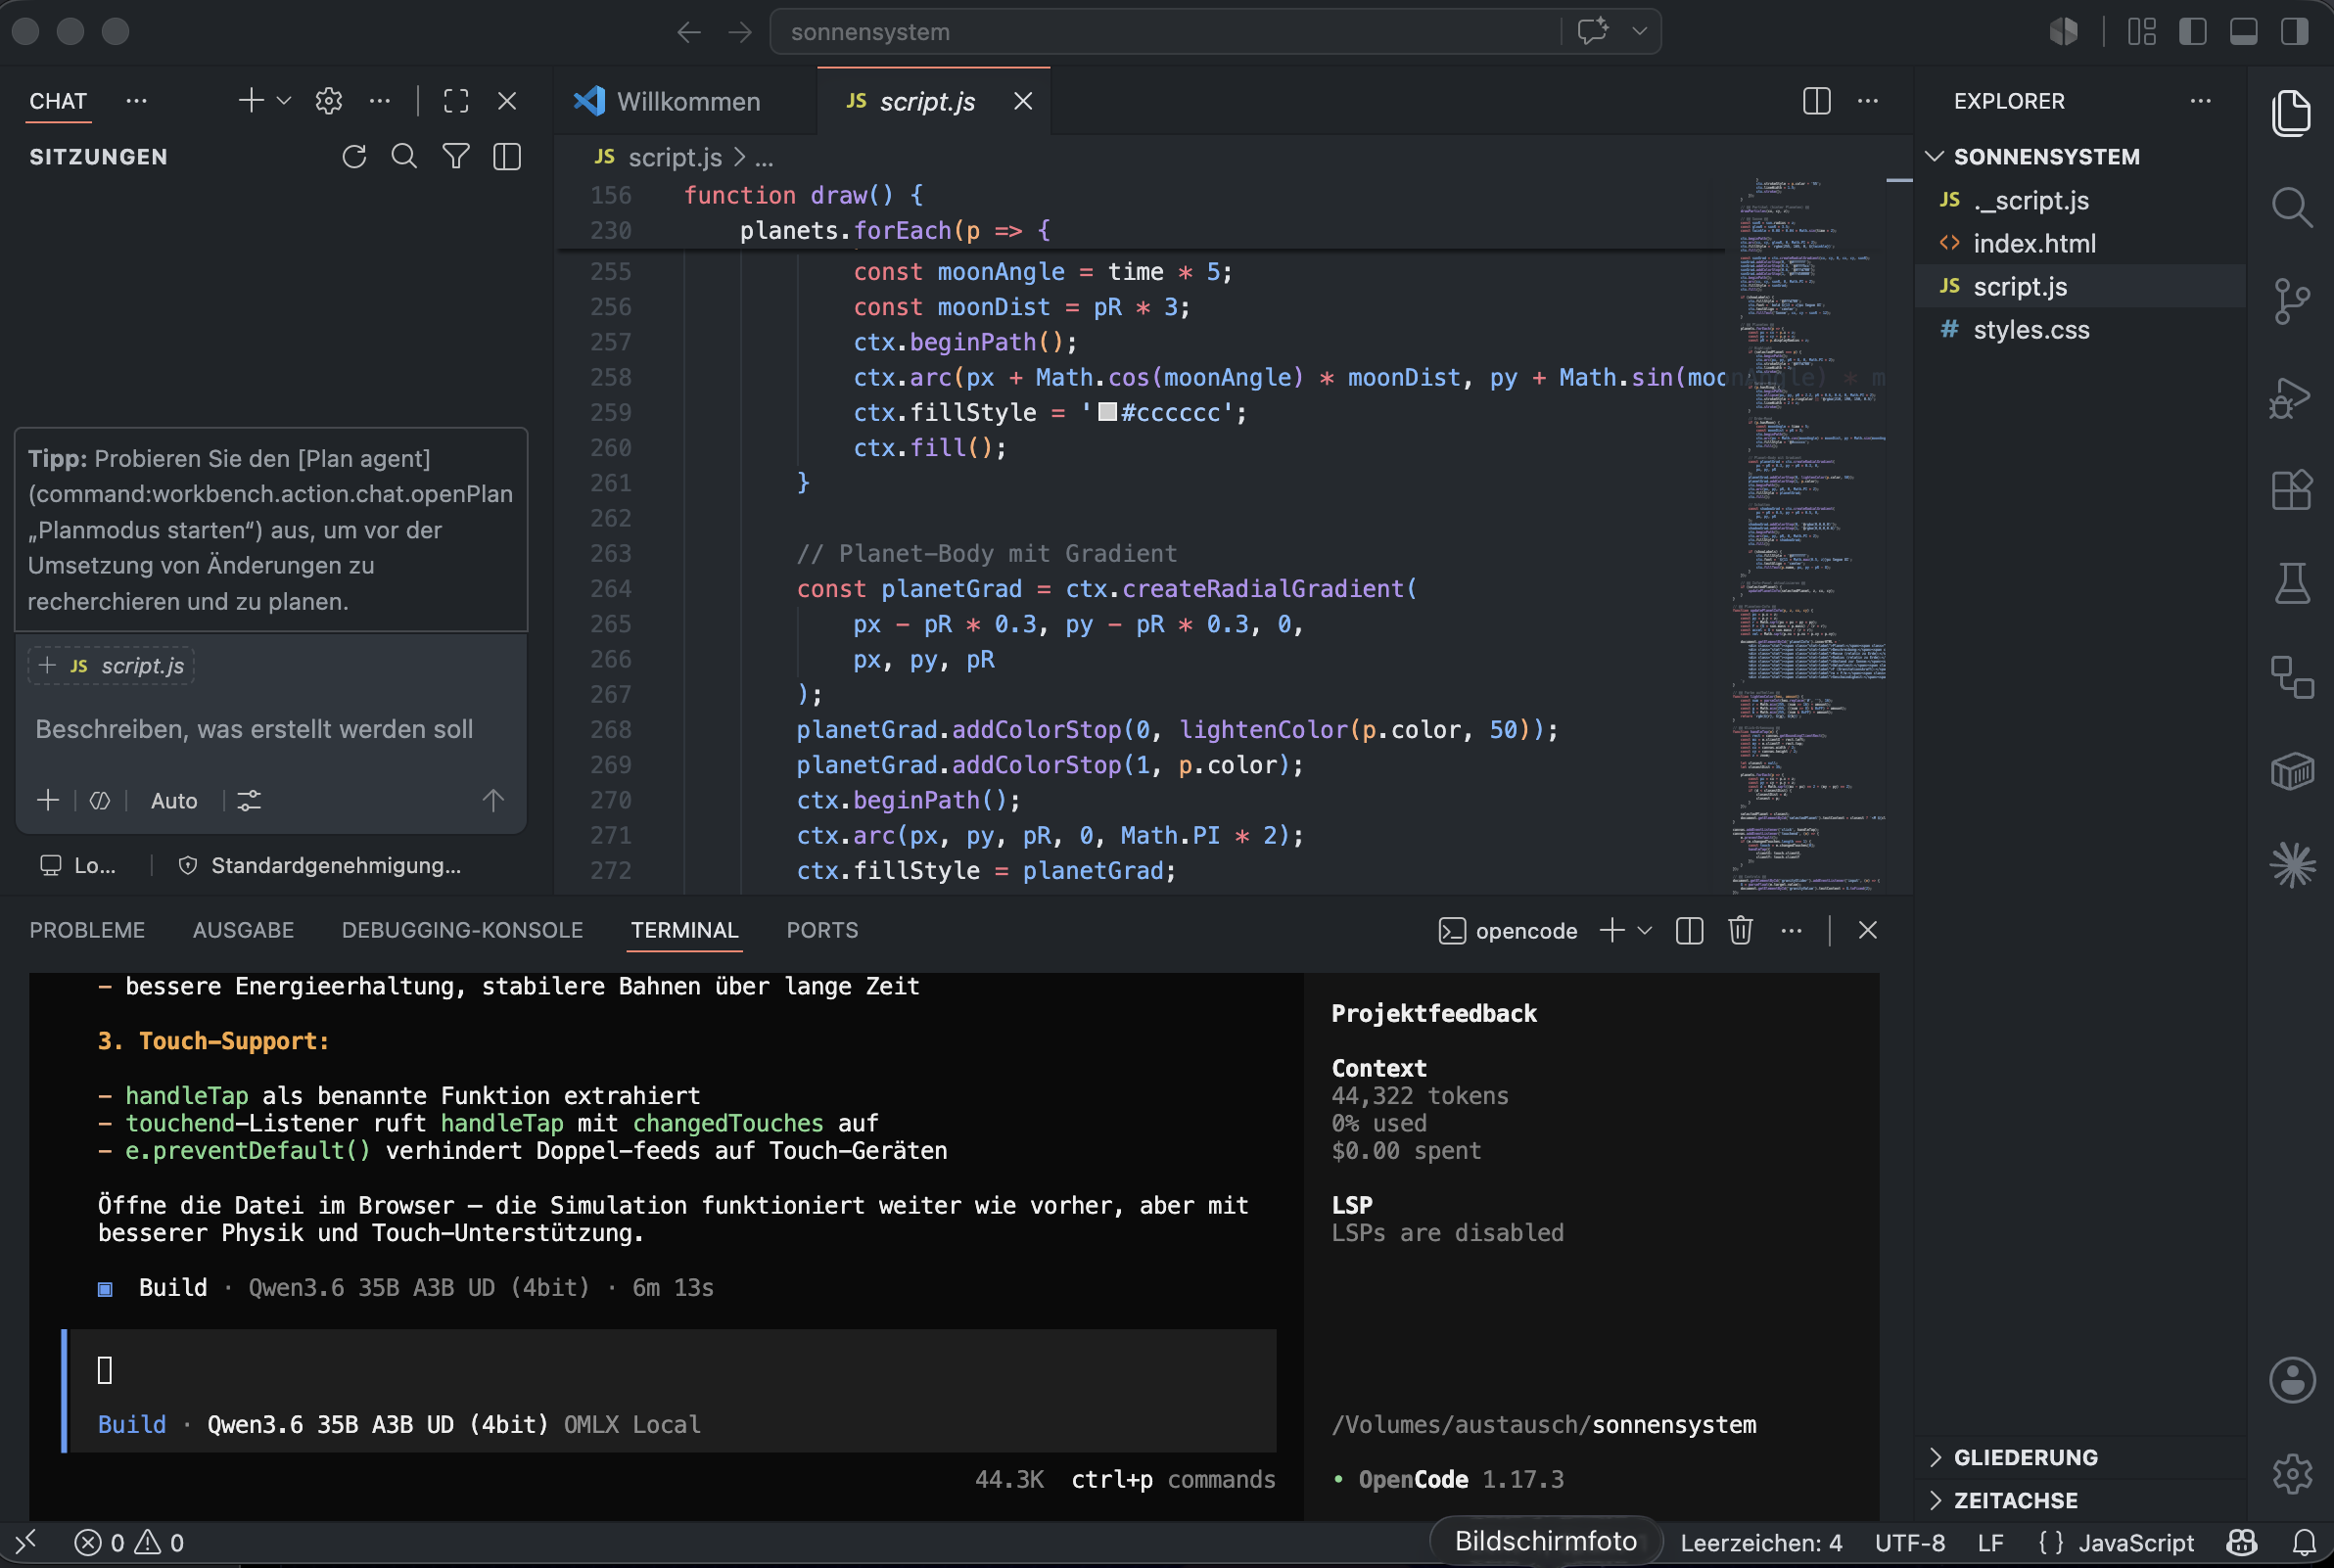
Getestet wird aktuell in VSCode und dort im Terminal über opencode. So kann ich wie gewohnt an den scripts mitarbeiten und da lokale LLM im VSCode laufen lassen.
Super cool!
Hast du mal Github Copilot ausprobiert? Das ist ja fester Bestandteil von VSC und untersützt mittlerweile auch die Nutzung eigener Modelle! Lokale Modelle müssten damit auch funktionieren
Hi, ja github copilot habe ich (auch ein Abo über die Firma). War mir aber noch nicht bewusst, dass dort auch lokale LLM genutzt werden können. Muss ich mir mal genauer anschauen, habe das daher bisher eigentlich immer so über opencode oder opencode cli in VSCode gemacht.
Da wäre ich mal gespannt, wie gut das funktioniert! Die Integration von copilot in VSC ist ja ziemlich cool aber die Cloudmodelle sind ziemlich teuer..
Wir haben auch nur das einfache Pro Abo. Reicht aber für unsere/meine Sachen aus. Dort stehen mir soweit alle wichtigen Modelle zur Verfügung, einschließlich claude sonnet. Claude opus haben sie leider gestrichen und ist jetzt glaube ich nur noch im Max Abo enthalten. Es können aber aktuell leider keine Abos mehr abgeschlossen werden (wurde ausgesetzt). Ich habe das zum Glück schon Anfang 2025 gemacht, da gab es die Probleme noch nicht.
Früher hatte man ein festes Kontingent für ein Stunden-Zeitfenster, was echt super war und jetzt haben sie es auf Tokennutzung umgestellt. Mit dem Abo bekommt man immer noch einigermaßen Nutzung heraus, ist aber natürlich durch das fehlende Zurücksetzen des Zeitfensters deutlich eingeschränkt. Jetzt ist es halt so, Token verbraucht, dann muss man einen Monat warten.
Copilot in VSCode funktioniert sehr gut, wird immer alles ordentlich erklärt, man sieht direkt wie gewohnt von github, die grünen/roten Passagen, wo neuer Code eingefügt oder entfernt wurde usw. Er denkt nach, bevor er etwas unternimmt und bietet nach Wunsch auch ein Plan an. Ist also wirklich schon gut integriert.
Ja, ich habe auch ein Cloudabo. Seit der neuen Abrechnung ist das aber kaum noch zu gebrauchen für mich. Nach 3 Tagen ist bei mir das monatliche Kontingent schon aufgebraucht
Das ist auf jeden Fall ein großer Vorteil von lokalen Modellen, dass man da nicht abhängig von zufälligen Preisänderungen ist
Ein Grund warum ich dahin möchte. Mein Hermes Agent hat im letzten Monat über 200M Token verbraucht. War auch ein intensiver Monat, aber trotzdem wenn man das bezahlen müsste, wäre ich Pleite.
Claude Abo haben wir auch noch in der Firma, wenn du da aktuell nicht das 4.8 opus, sondern 4.7 nutzt geht es einigermaßen mit den Token. Und Fable hätten sie auch nicht herausbringen brauchen, wer soll das nutzen, bei den Kosten. Eine Anfrage und das Kontingent ist aufgebraucht.
Nicht mehr, mache heute noch noch einige Websites und lokale Software für die Firma. Da hat sich im letzten halben Jahr einiges verändert und vereinfacht die internen Abläufe. Für die Monteure gibt es jetzt auch eine App (mit Backend-Server für uns im Büro), wo sie die nächsten Bauvorhaben abrufen können, zwecks Adresse und Doku vor Ort. Da ist heute soviel möglich, was ich allein so früher nicht hinbekommen hätte.
Habe also schon genug damit zu tun, auch wenn es nicht mein Beruf ist. EDV mache ich bei uns komplett in der Firma. Kann ja nicht Schaden, sich damit etwas auszukennen.
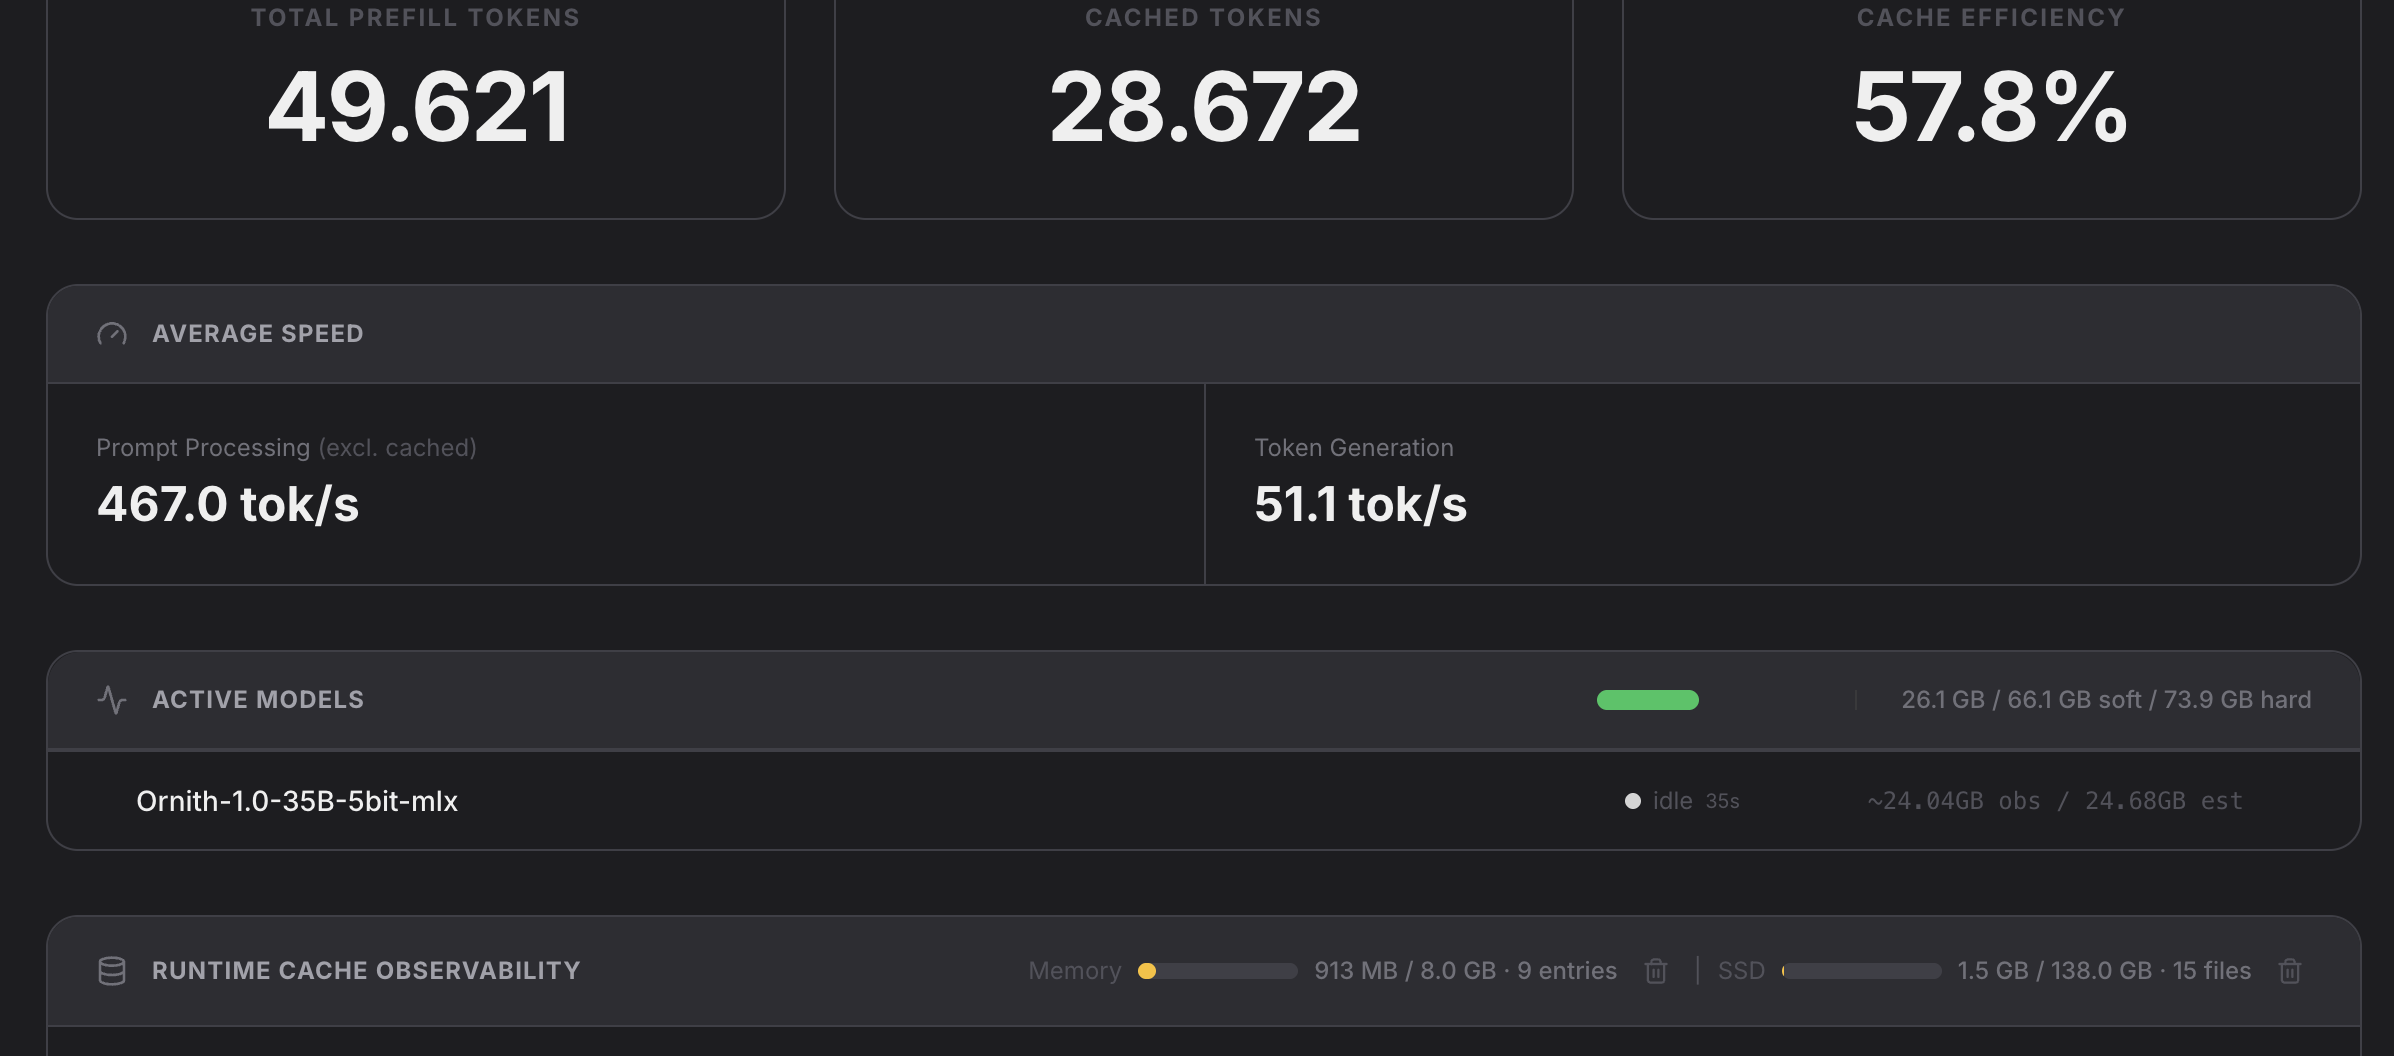
Habe heute mal wieder ein neues LLM (ornith 1.0 35b - 5bit) getestet und gefällt mir bisher sehr gut, werde ich morgen mal tagsüber laufen lassen. Es gibt das LLM in verschiedenen Größen und so sollte für jeden etwas dabei sein. Geht bei 9b los, was auf sehr kleiner Hardware läuft und reicht über 31b und 35b bis 397b. Die letzten beiden laufen mit Moe und nutzen daher nur einen Teil ihrer Parameter, sind aber dafür auch schneller.
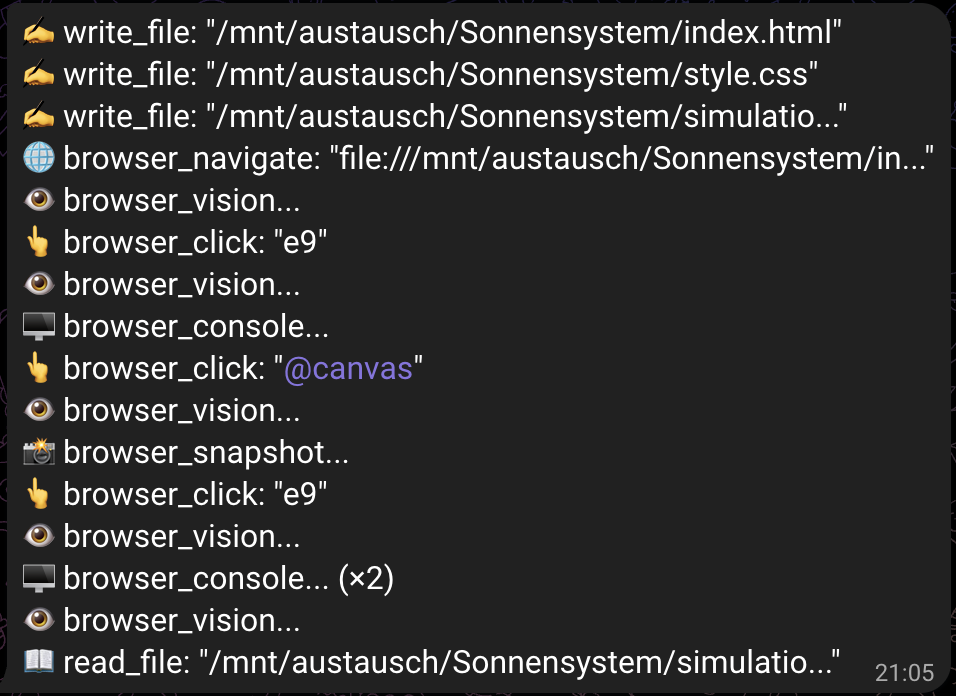
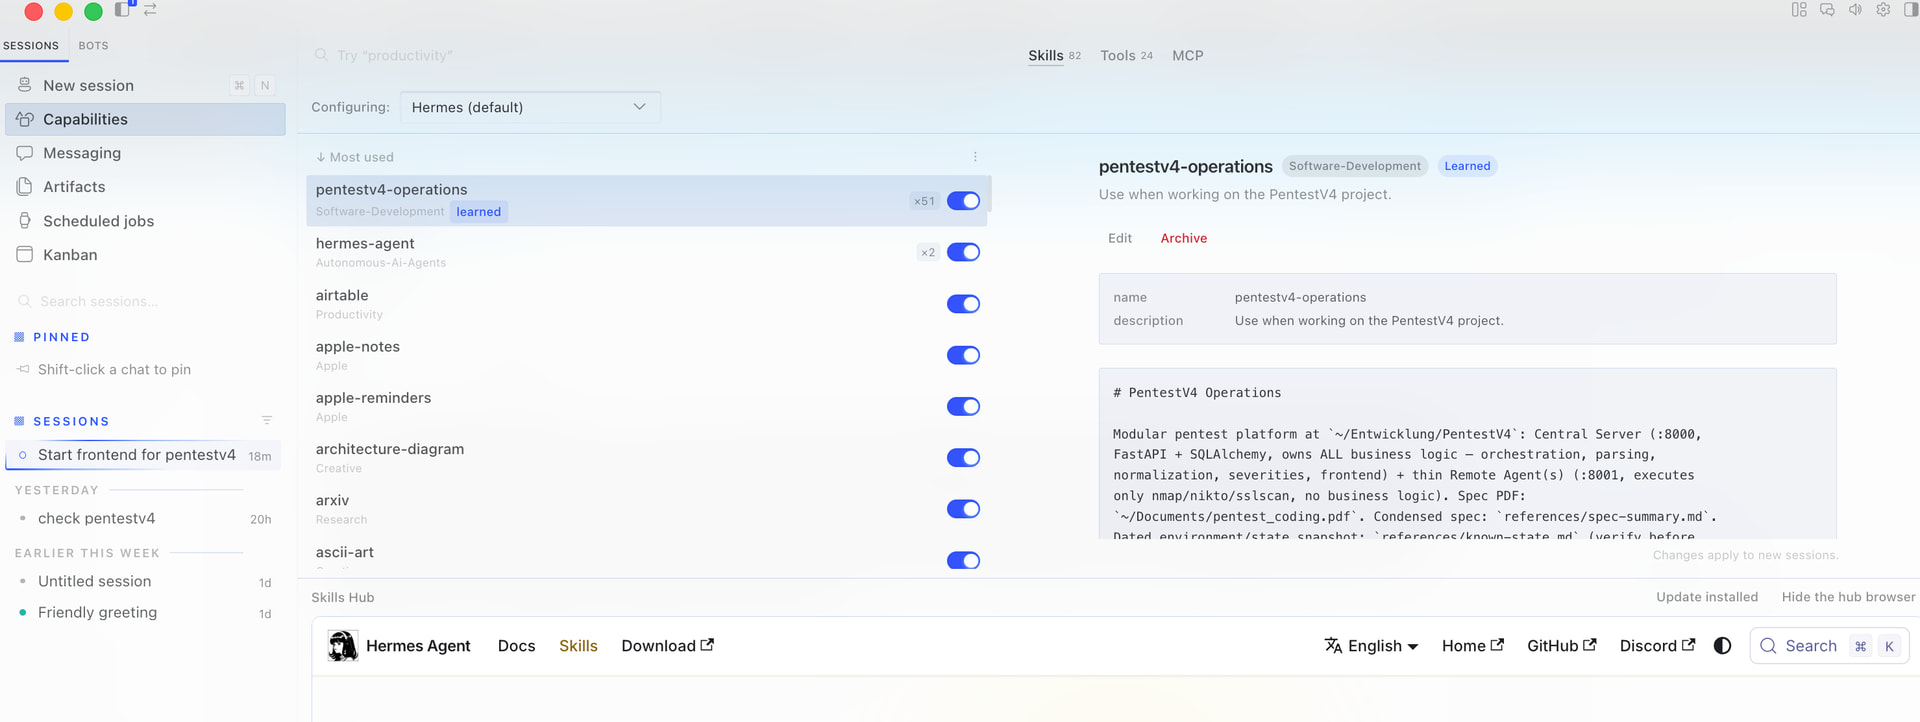
Aufgabe wurde korrekt gelöst! Das LLM ist ein Mix aus qwen 3.5 und gemma4. Es hat wirklich sehr gute Benchmarks und nutzt z.B. im Hermes Agenten sehr gut die vorhandenen Tools. Hier mal ein Beispiel, das ist es eindeutig besser wie gemma4 oder qwen.
Hi, habe heute das neue ornith1.5-35B-A3B-8Bit heruntergeladen und getestet. Ich weiß Qwen3.8 ist auch gerade herausgekommen, leider läuft das aber nicht wirklich schnell auf dem Mac. Habe immer so um die 10tok/s bei Qwen und ohne thinking komme ich so auf knapp 18-20tok/s. Beides nicht wirklich brauchbar für die tägliche Arbeit. Daher habe ich mich gestern gefreut, vom neuen ornith1.5 zu lesen.
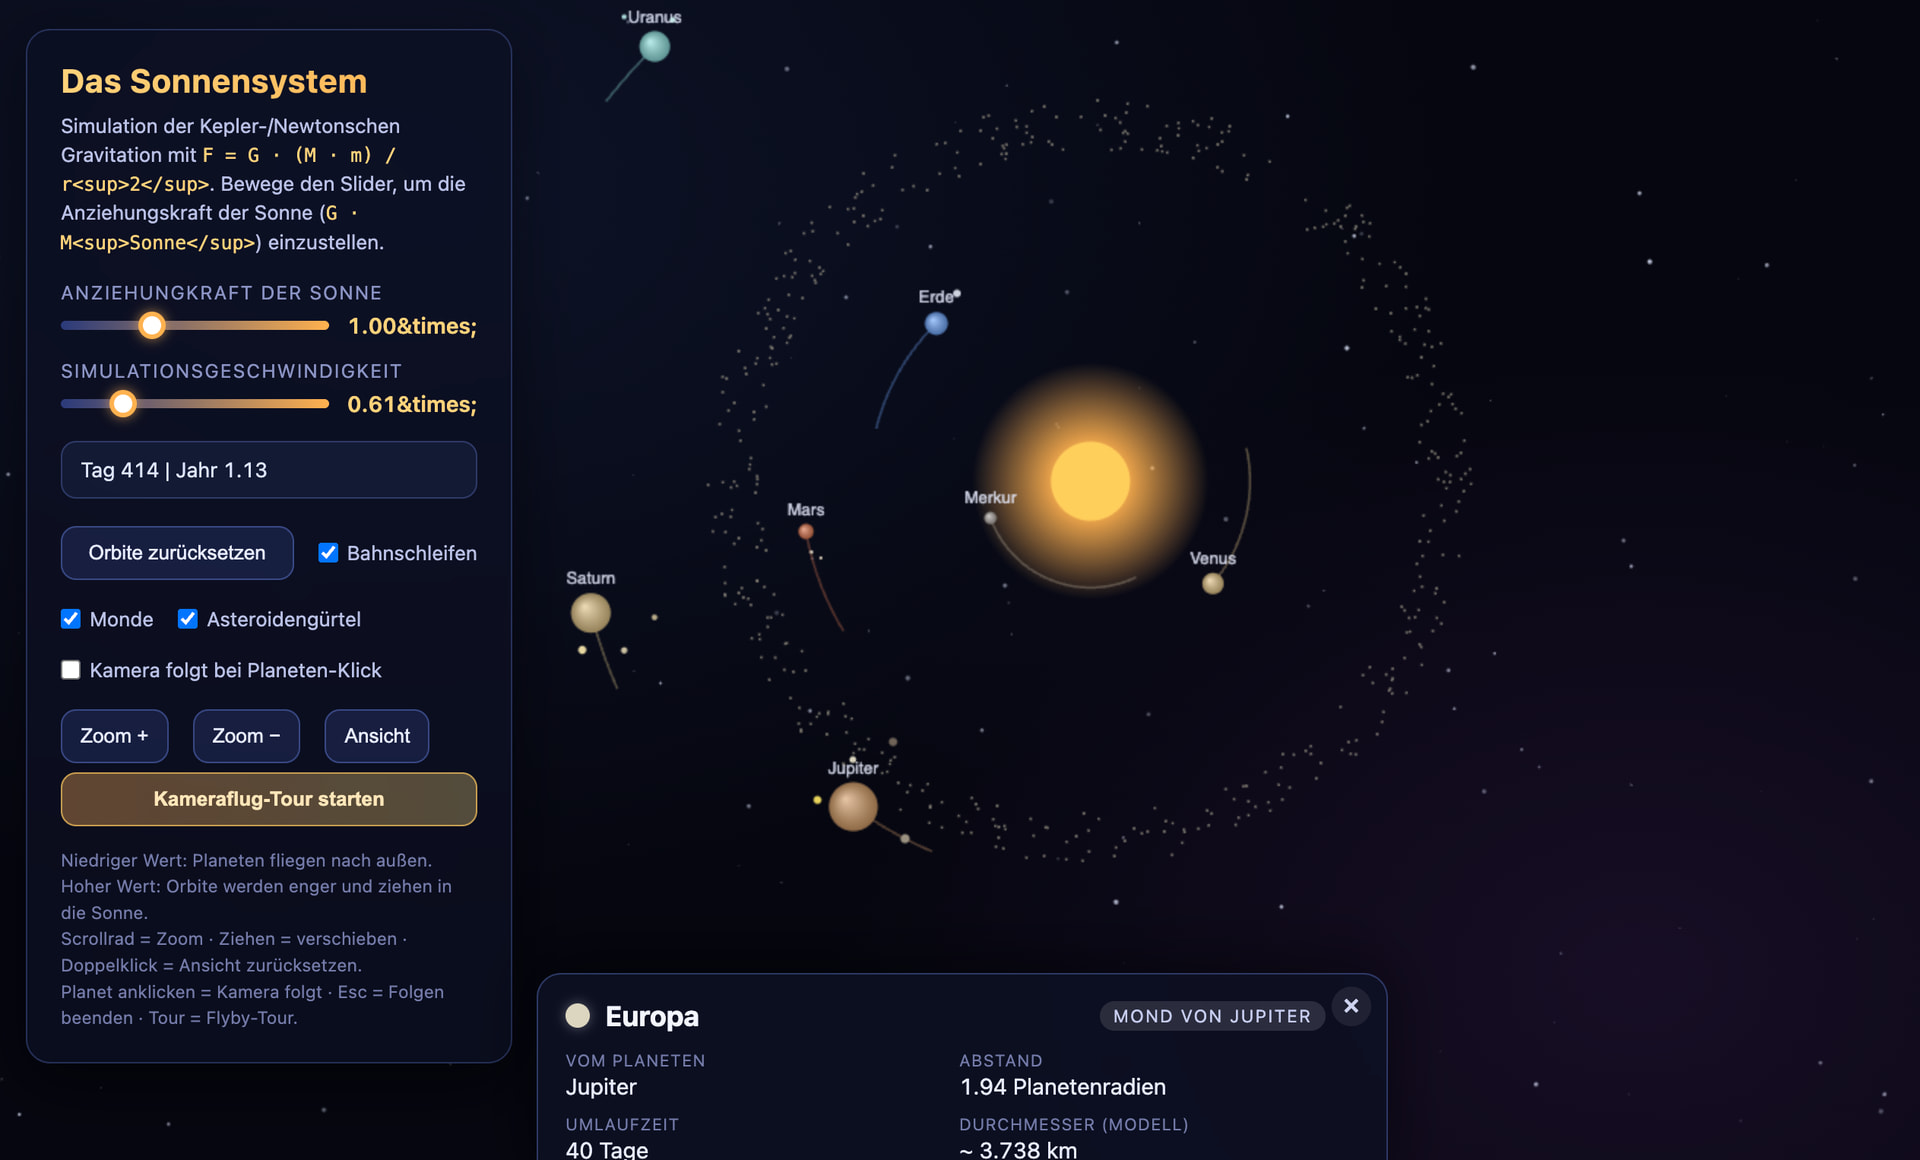
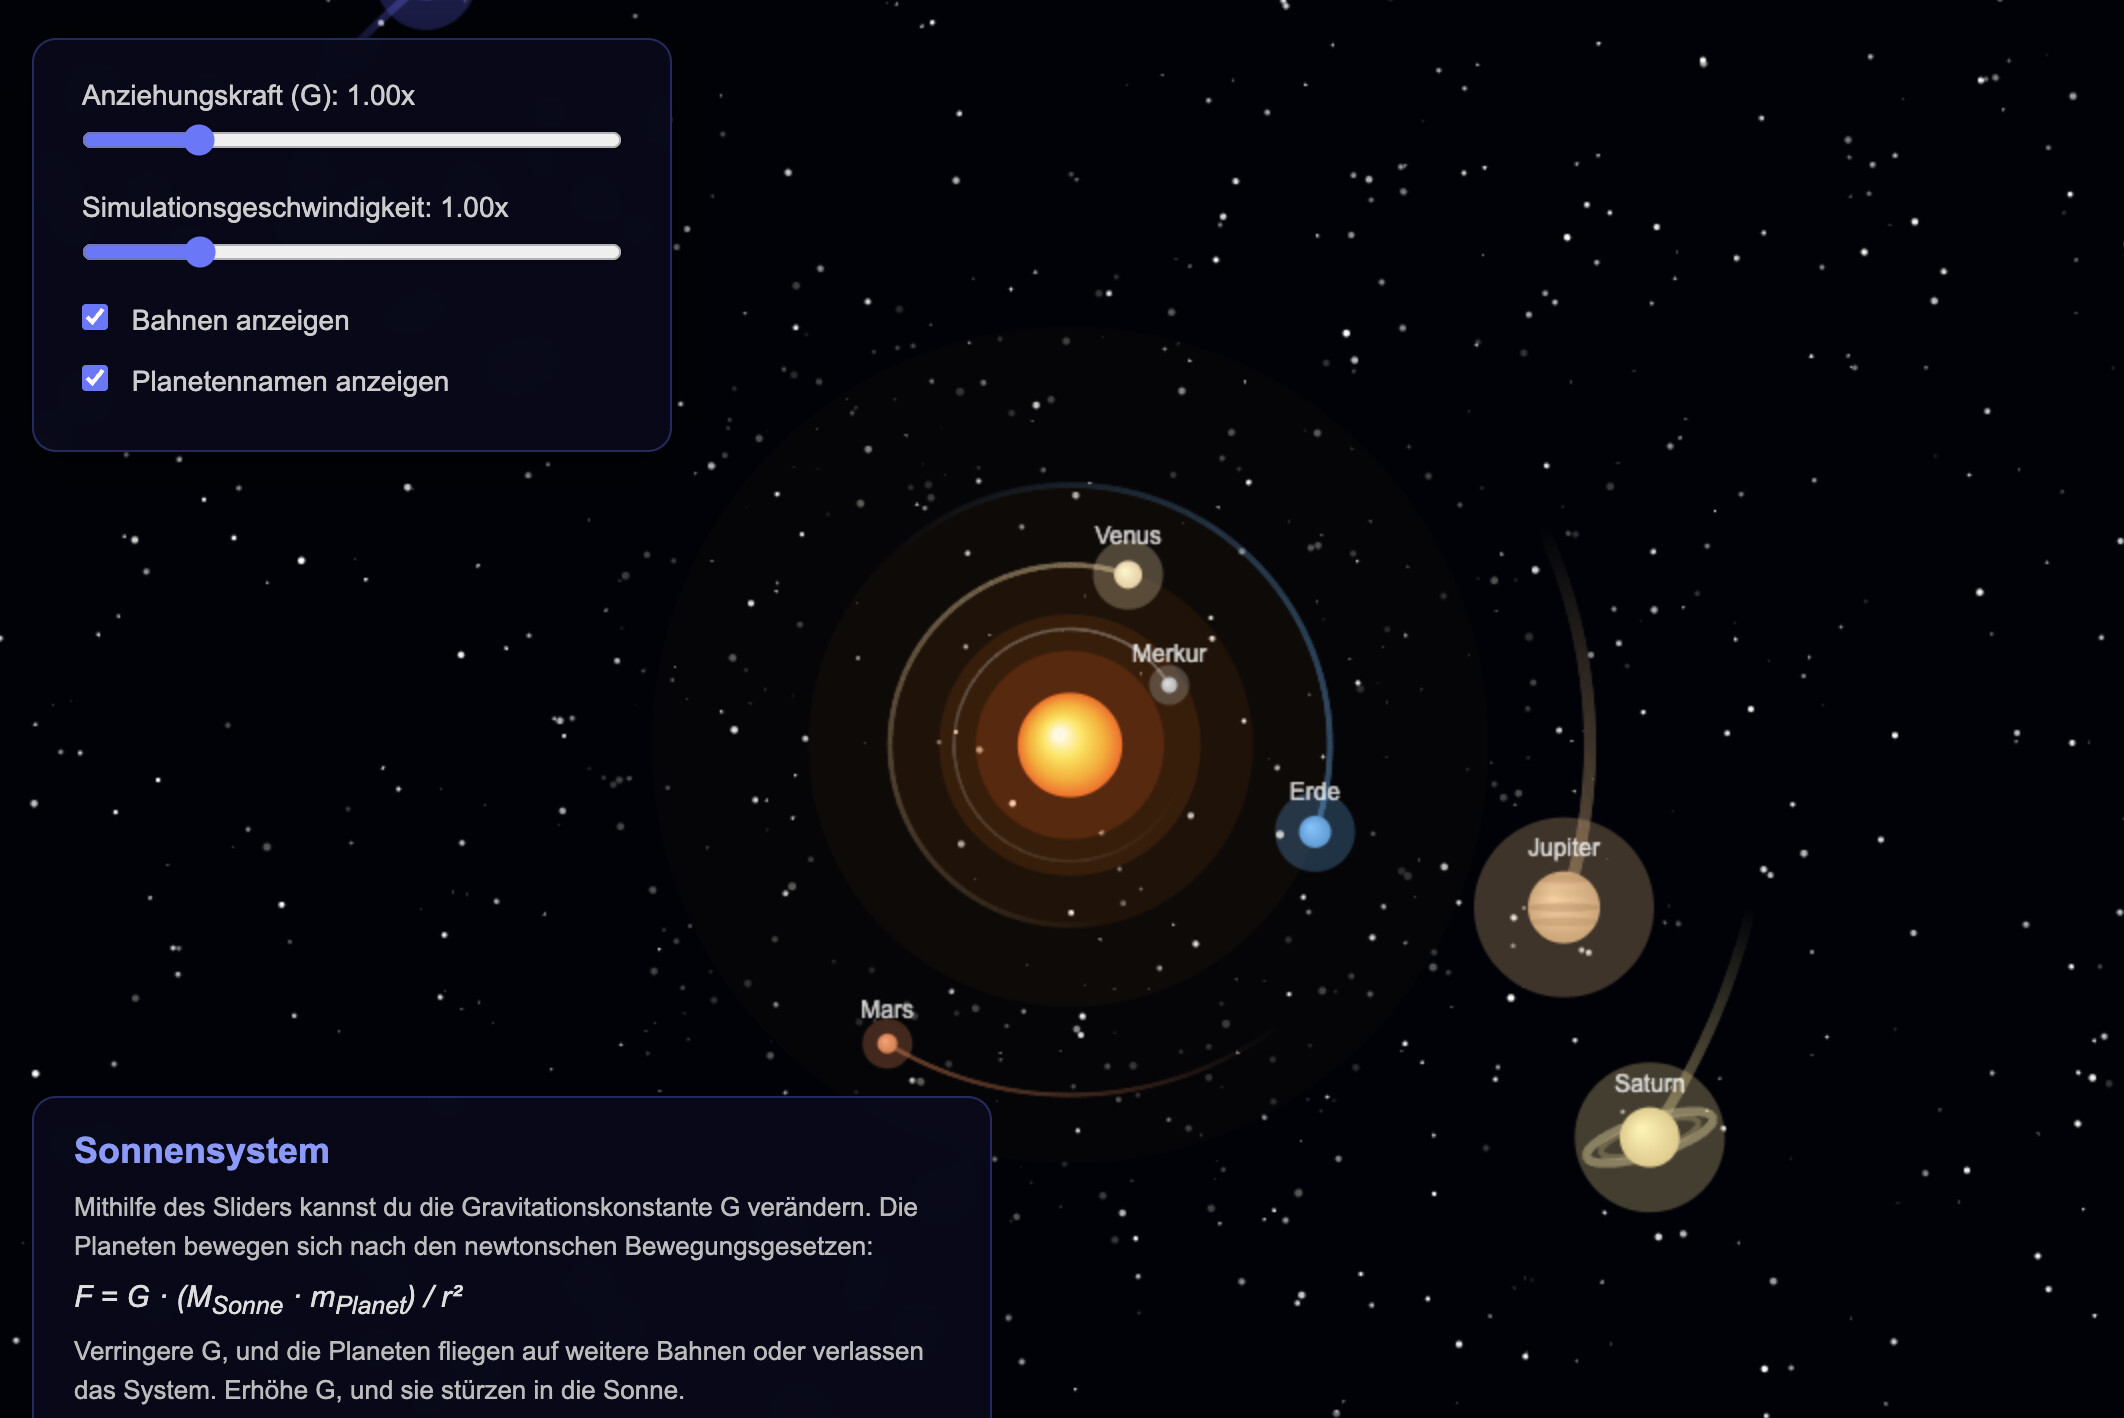
Dann habe ich wie immer mein Sonnensystem erstellen lassen und wurde mit dem ersten Prompt direkt korrekt erstellt. Habe es dann noch ausbauen lassen, so dass auch die Monde zu sehen sind. Das ist bisher mein bestes Ergebnis zum Sonnensystem und ich habe ja nun schon einige lokale Modelle getestet.
Die optische Darstellung schaut auch echt schön aus und bietet eine Menge Infos. Hintergrund mit Sternen und Asteroidengürtel hat er direkt selber ergänzt, ohne weitere Nachfrage oder Korrekturen.
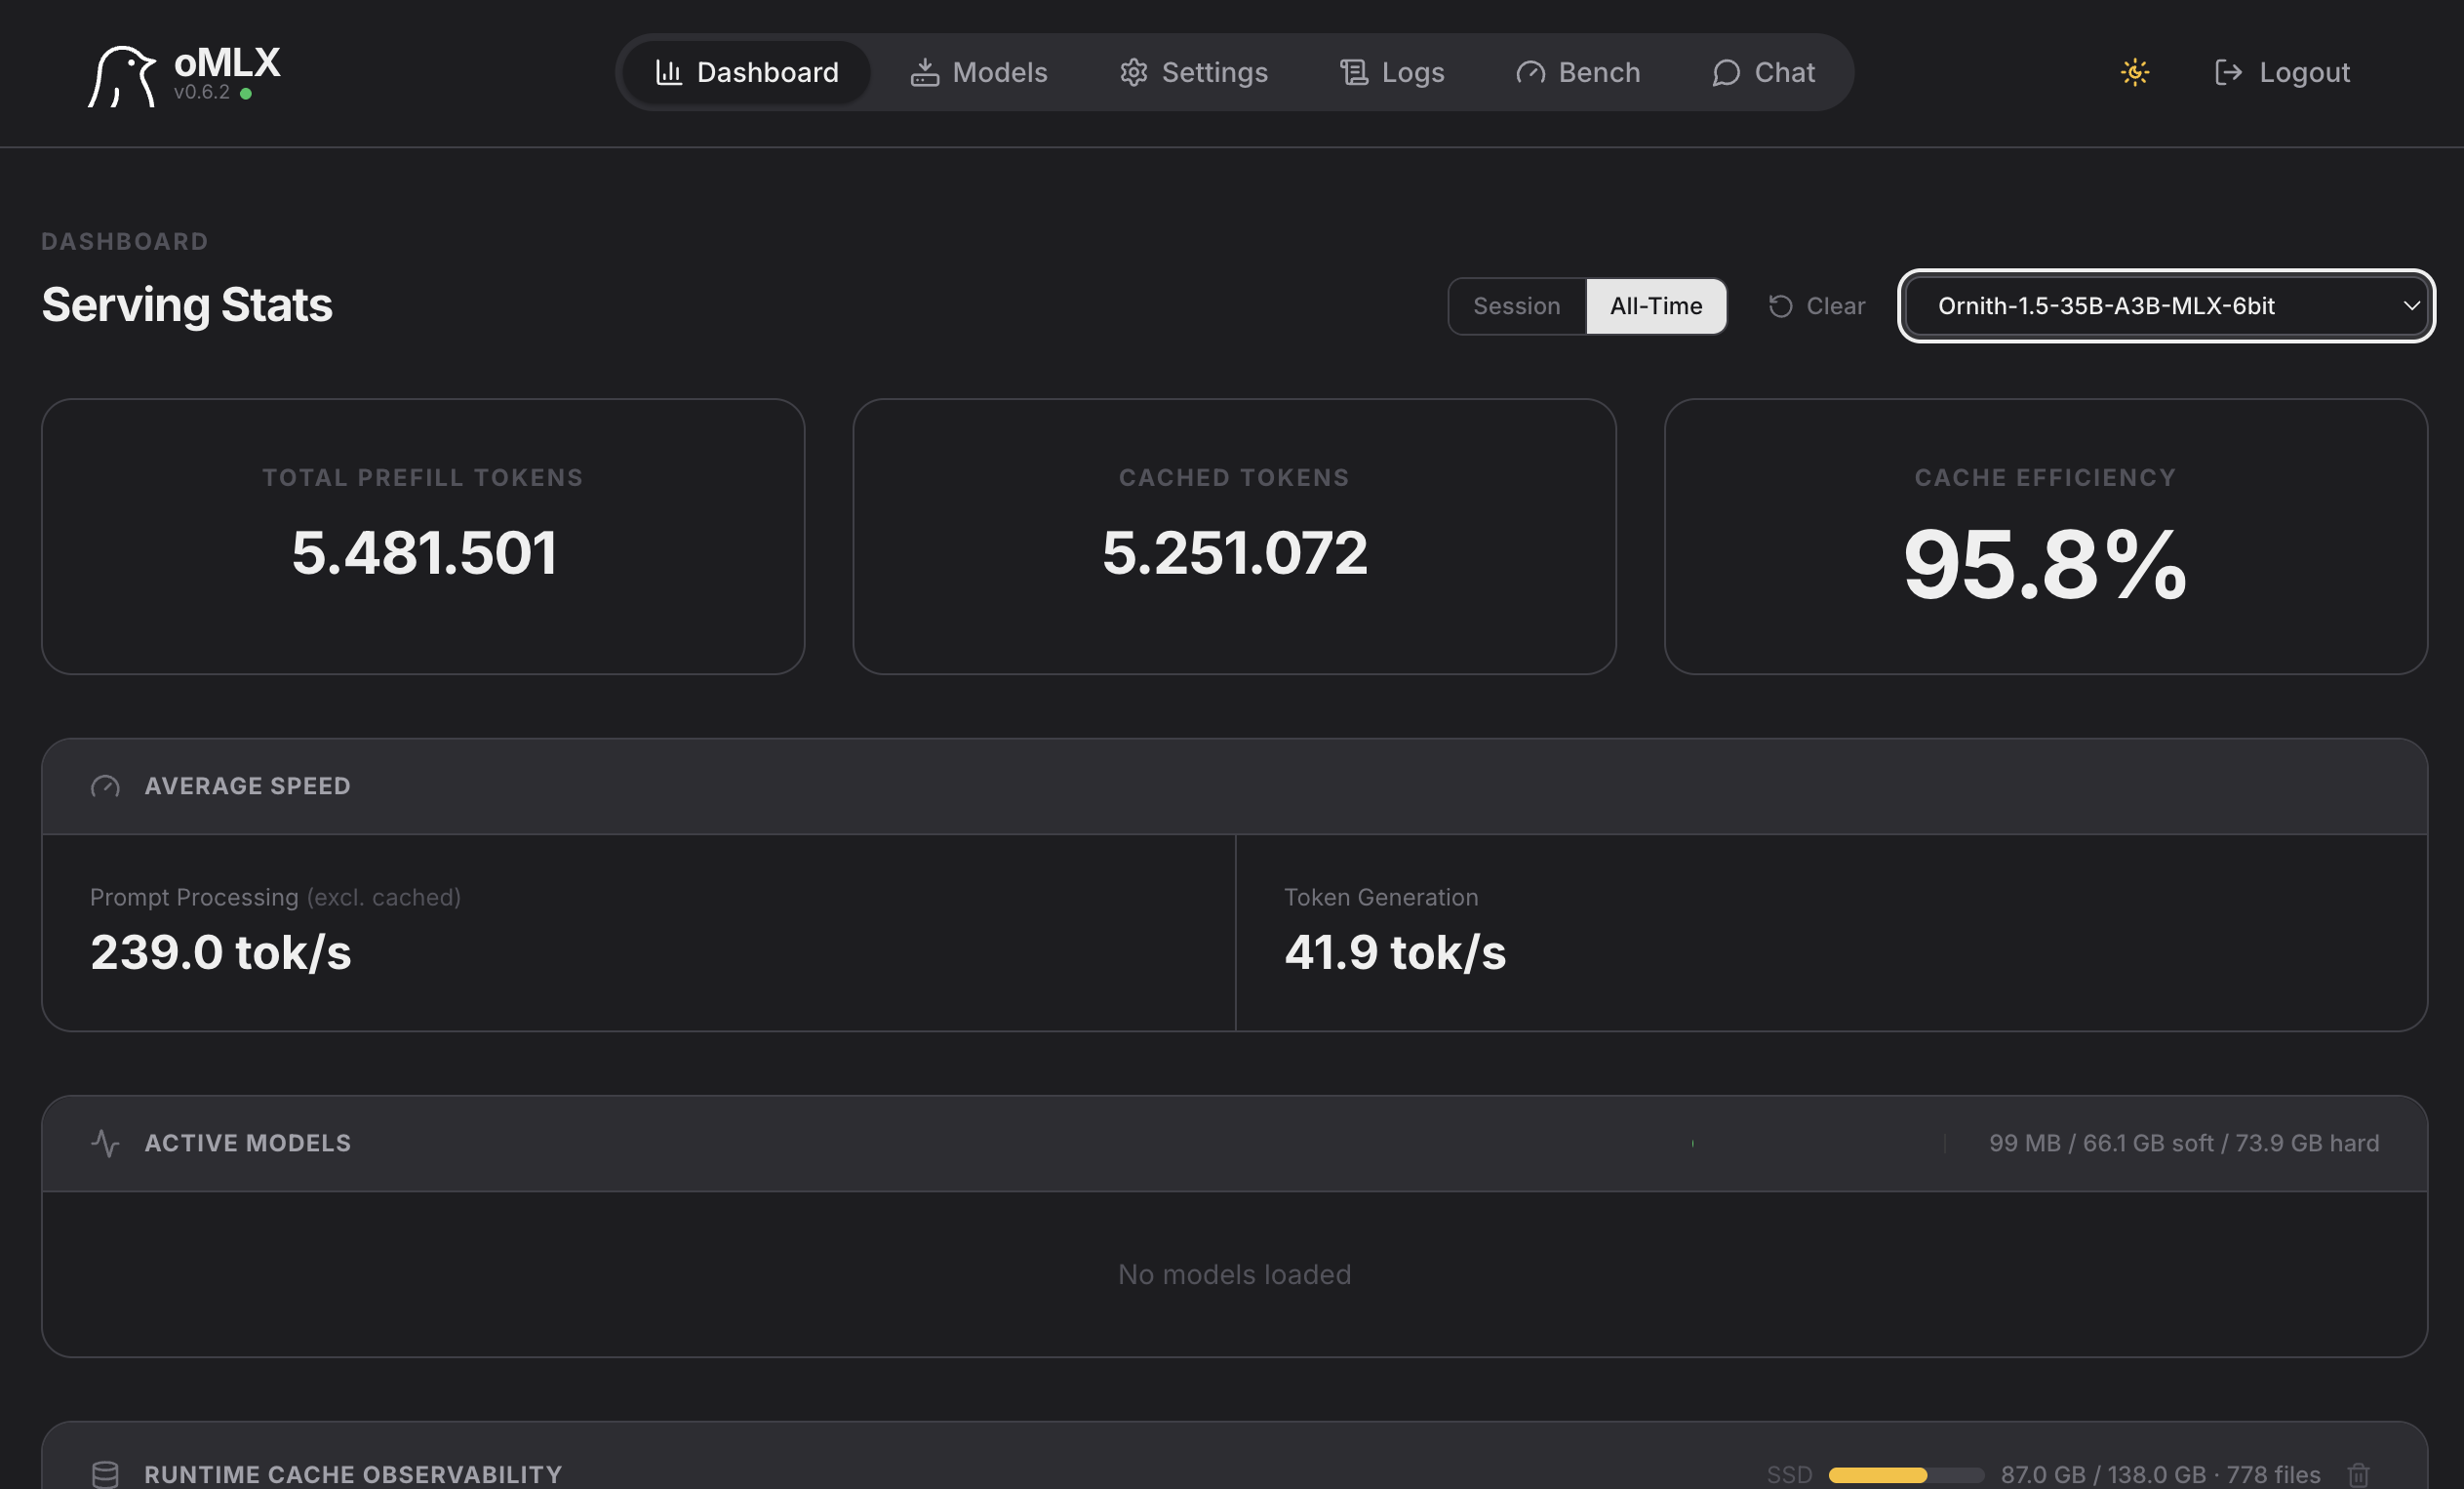
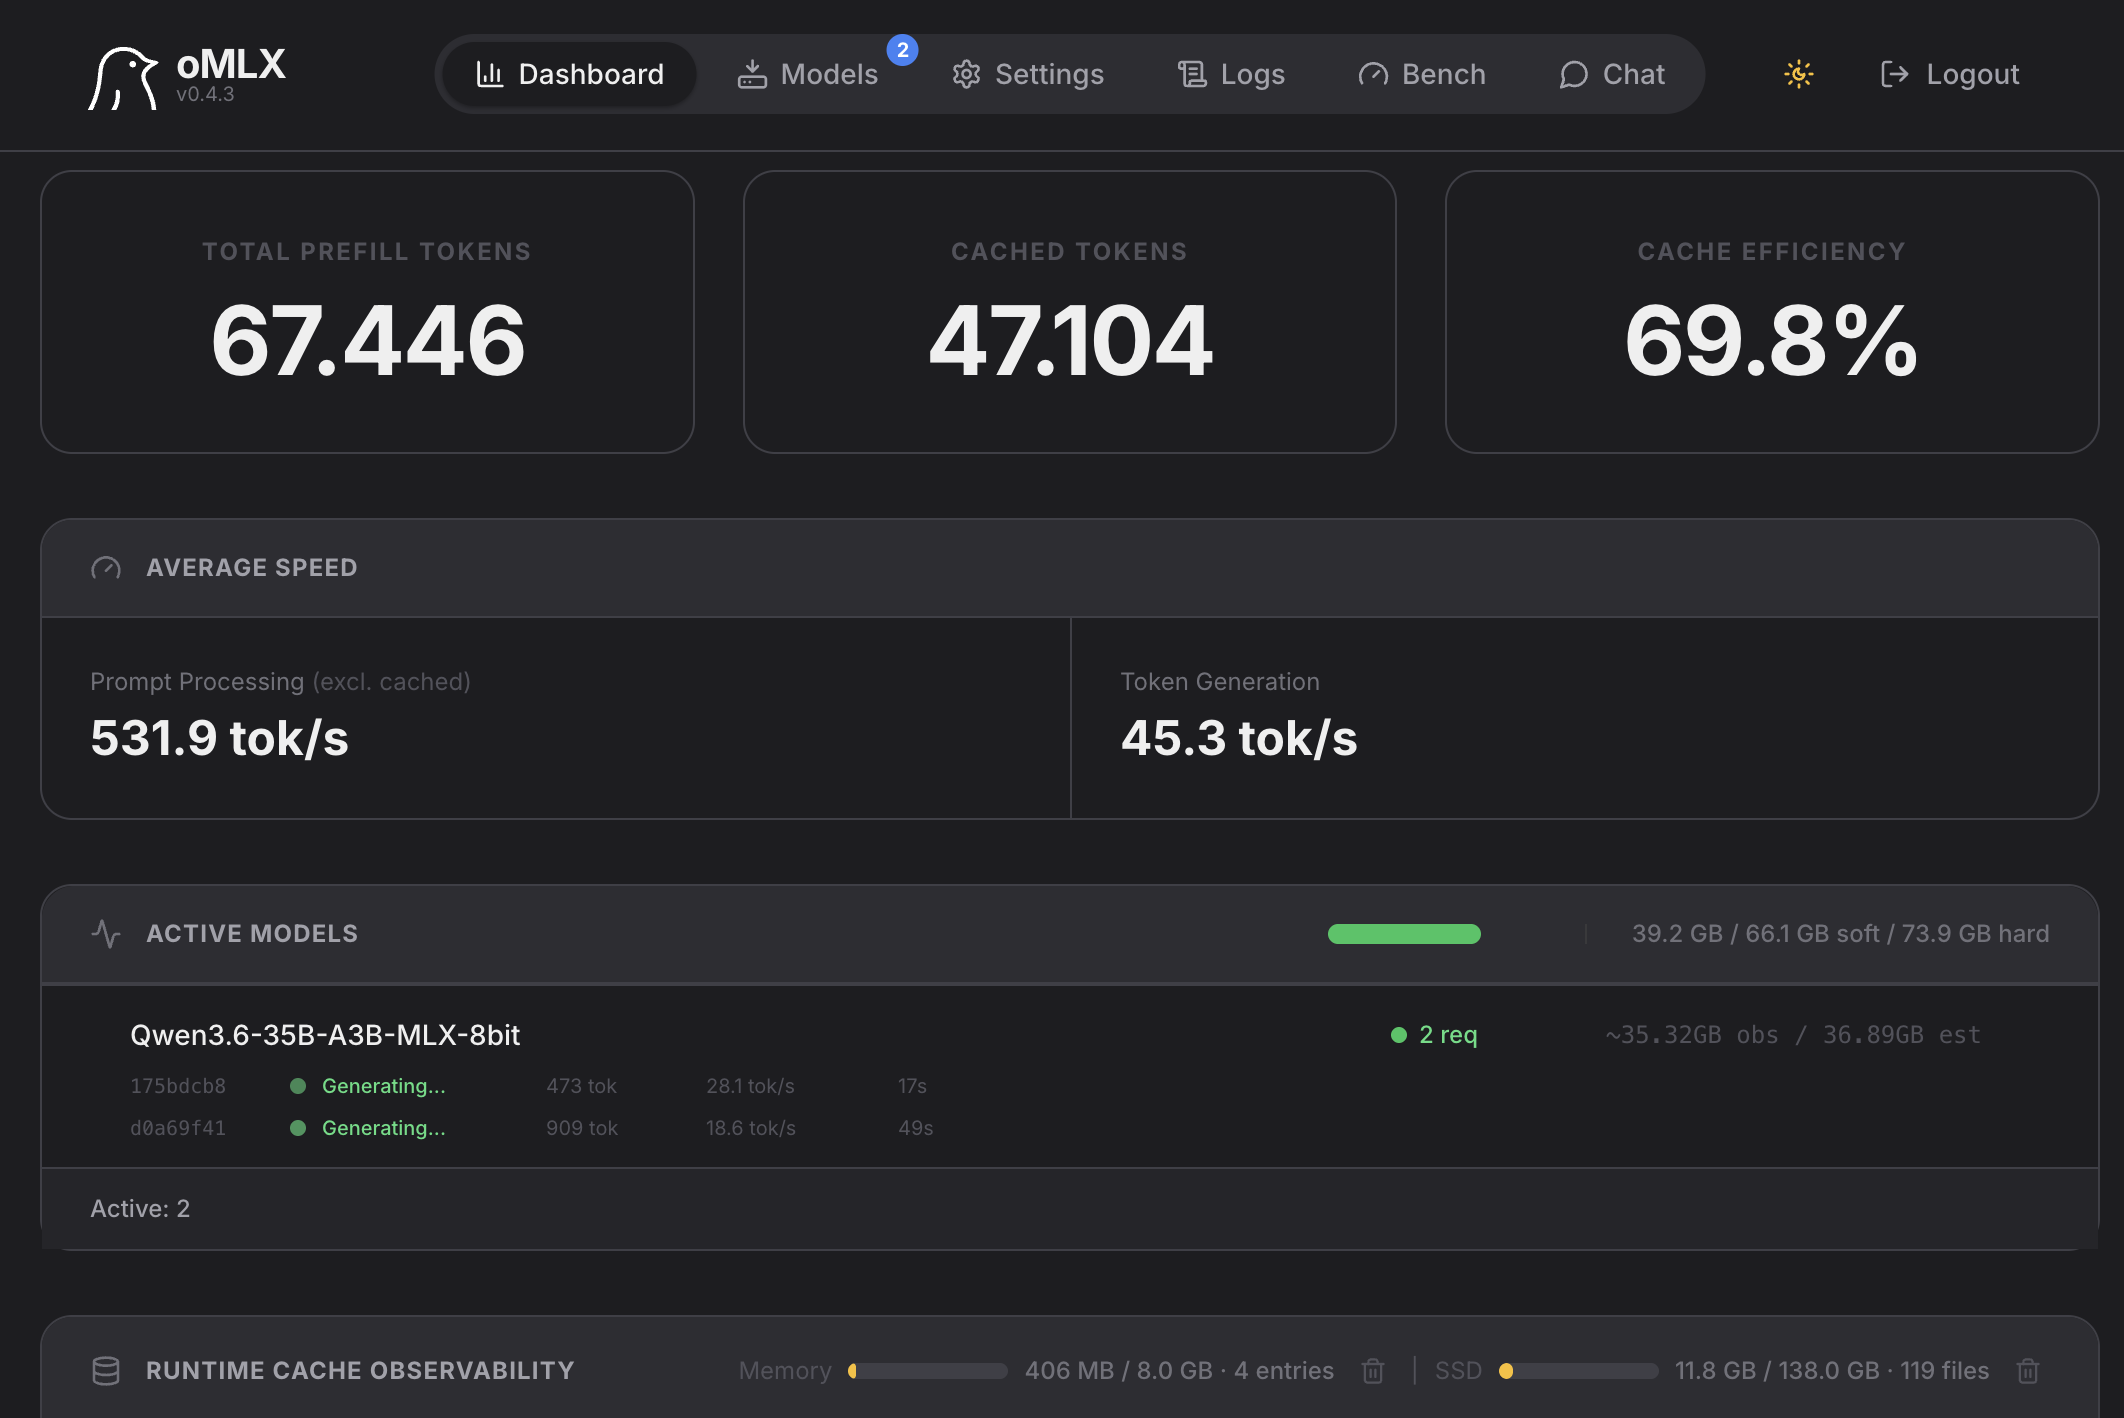
Selbst nach den 5 Mio Token, hat er immer noch knapp 42 tok/s, ein echt guter Wert bei 256K Kontextfenster. Zu Beginn, bis ca. 1,5 Mio Token habe ich noch die 50 tok/s erreicht. dann ist er leicht gefallen, wegen der Auslagerung (Cache) auf SSD. Das kann aber auch abgeschaltet werden und so ist wird der Cache im RAM statt auf der SSD geführt. Dann sind die Token/Sekunde nochmal etwas schneller, aber man braucht dann wirklichen freien RAM.
Ornith1.5 gibt es auch als 9B Variante und sollte damit auch auf kleiner Hardware sehr gut laufen. Ich bleibe bei der 35B Variante, weil das bei alles gut in meinen VRAM passt. Laut Benchmarks, soll ornith1.5 mit Qwen3.8 mithalten oder sogar besser sein. Beim Qwen3.8-27B Test wurde das Sonnensystem auch korrekt erstellt, aber die gravitationskräfte wurden nicht korrekt berechnet (Planeten drehten sich nur schneller oder langsamer). Ornith hat das direkt korrekt erstellt und berechnet.
Damit wird ornith zu meinem neuen tägl. Begleiter (also auch für Hermes Agent)
da werde ich dann doch stutzig. natürlich funktioniert vieles nicht oder nicht richtig und der frust ist schnell da.
ich habe auf meinem macbook air M4 mit 16gb llm mit den models qwen3.5-9b und gemma 4 e4b. voher hatte ich gemma 4 12b qat installiert. ich bin ziemlich enttäuscht.
dann habe ich parallel copliot von m$ installiert (da auch in der firma genutzt) und zack hatte ich eine wetterkarte, welche im eingeklappten zustand nur die derzeitige temperatur und die vorhersage für die nächsten 6 tage. die karte und der rahmen ist eingefärbt abhängig der wetterlage. wenn ich die karte aufklappe, habe ich eine stündliche vorhersage für bspw. 10 stunden und darunter eine horizon karte. leider kann die karte nicht automatisch wieder einklappen.
Ich hab tatsächlich jetzt den Hermes Agent als Entwicklungsumgebung wenn man so will - der HUD Mode hilft mittlerweile auch ganz gut für Frontend Debugging - das steht bei mir aber noch am Anfang. Noch bleibt bei mir Qwen 3.5 122B 4Bit die Wahl fürs coden - hab ja den Luxus eines M5 mit 128GB und da läuft das schnell genug mit Context und im Zweifel noch ein Minimodell für Hindsight. Jetzt wo du aber Ornith erwähnst - wär mal für so ein paar Dinge und den konfigurierten Bots wie Researcher etc. denkbar - danke für den Input…


 EDV mache ich bei uns komplett in der Firma. Kann ja nicht Schaden, sich damit etwas auszukennen.